在之前的文章中,我已经向大家详细介绍过 LightNode 的基本情况了。它和大家熟知的 Vultr 类似,也是按小时计费的云服务商。
很多准备建站或者跑项目的朋友,一定都非常关心 LightNode 的实际运行表现到底怎么样。为了给大家提供一个最客观的参考依据,我专门开通了一台美国华盛顿节点的共享 CPU 实例进行了深度测试。接下来,我将通过一系列真实的测试带你全面了解这台 VPS。
让我们直接进入正题,看看它在各项指标下的具体成绩吧。
基础配置与套餐详情
为了让大家对本次测试的对象有一个直观的了解,我选择的是 LightNode 华盛顿机房的入门级方案。这个套餐的配置信息清晰明了,对于部署中小型网站或者一些日常的后端开发测试来说,通常已经足够应付了。
| 配置项目 | 详细参数 |
|---|---|
| 机房位置 | 美国 华盛顿 |
| CPU 核心 | 1 vCPU 高性能 |
| 内存容量 | 2 GB DDR4 |
| 硬盘空间 | 50 GB NVMe SSD |
| 月标流量 | 1 TB 传输流量 |
| 套餐价格 | $7.71 / 月 |
| 购买链接 | 立即购买 |
单看价格的话,这个方案其实比 Vultr 的同类配置要稍微贵一点点。不过需要注意的是,LightNode 的流量统计规则只计算单向的出网流量,因此在实际使用中可用的网络流量会显得更多一些。
俗话说得好,纸上得来终觉浅,购买之后我们还是需要进入系统内部,通过命令行来彻底核实一下这台机器的真实底层硬件配置。
root@qckfryga:~# lscpu | grep "Model name"
Model name:                Intel Xeon Processor (Skylake, IBRS)

root@qckfryga:~# free -h
               total        used        free      shared  buff/cache   available
Mem:           1.9Gi       142Mi       1.5Gi       2.0Mi       246Mi       1.6Gi
Swap:             0B          0B          0B

root@qckfryga:~# df -h /
Filesystem      Size  Used Avail Use% Mounted on
/dev/vda2        50G  3.0G   48G   6% /
从实际反馈的配置信息来看,CPU 选用的是英特尔至强(Skylake)处理器,其虚拟化架构的规格表现还是比较标准的。同时,内存和 NVMe 硬盘的可用空间也都没有出现任何缩水的情况,这就为接下来的各种高负载跑分测试和路由追踪打下了坚实的基础。
LightNode 性能深度实测
既然这台机器使用的是 Intel Xeon 的 CPU ,那么它的实际运算能力和磁盘读写速度到底能不能抗压呢?为了给大家最真实的参考数据,我直接上了两款业界最常用的测试工具来进行跑分。下面就让我们来看看它在基础运算和磁盘 I/O 上的具体表现。
CPU 运算性能测试
首先登场的是著名的 Sysbench 工具,我特意跑了一个 60 秒的单核 CPU 性能压测,表现算是中规中矩。
root@qckfryga:~# sysbench cpu --time=60 run
CPU speed:
    events per second:   896.94

General statistics:
    total time:                          60.0015s
    total number of events:              53820
单核每秒处理事件数达到了 896.94 次,这个成绩应对普通的 WordPress 博客或者中小型流量的业务站点是毫无压力的。只要你不拿它去跑特别重度的密集计算任务,这颗 CPU 的性能已经足够日常折腾了。
磁盘读写速度压测
对于经常建站的朋友来说,服务器的磁盘读写速度直接决定了网站数据库的响应快慢。为了测试这块 NVMe SSD 的真实水平,我使用 fio 工具分别进行了 4K 随机写入和随机读取的极端压测。
# 4K 随机写
root@qckfryga:~# fio --name=randwrite --ioengine=libaio --iodepth=1 --rw=randwrite --bs=4k --size=1G --runtime=60 --time_based
  write: IOPS=47.7k, BW=186MiB/s (195MB/s)(10.9GiB/60001msec); 0 zone resets

# 4K 随机读
root@qckfryga:~# fio --name=randread --ioengine=libaio --iodepth=1 --rw=randread --bs=4k --size=1G --runtime=60 --time_based
  read: IOPS=7406, BW=28.9MiB/s (30.3MB/s)(1736MiB/60001msec)
除此之外,使用最经典的 Bench.sh 综合测试脚本跑出来的平均 I/O 速度也能作为一个很好的直观参考,结果如下:
----------------------------------------------------------------------
 I/O Speed(1st run) : 371 MB/s
 I/O Speed(2nd run) : 517 MB/s
 I/O Speed(3rd run) : 486 MB/s
 I/O Speed(average) : 458.0 MB/s
----------------------------------------------------------------------
为了让大家看得更直观,我把上面又长又繁琐的终端输出数据做了一个精简汇总。
| 测试项目 | 核心指标 | 测试结果 |
|---|---|---|
| 4K 随机写入 (Fio) | IOPS | 47.7k |
| 4K 随机写入 (Fio) | 吞吐量 (BW) | 186 MiB/s |
| 4K 随机读取 (Fio) | IOPS | 7406 |
| 4K 随机读取 (Fio) | 吞吐量 (BW) | 28.9 MiB/s |
| 顺序读写 (Bench.sh) | 平均速度 | 458.0 MB/s |
可以看出这块 NVMe SSD 的随机写入表现还不错,能够跑到 47.7k 的 IOPS 数据,但是算不上优秀。虽然 4K 随机读取的速度稍微偏弱一点,但综合 458.0 MB/s 的平均顺序速度来看,用它来跑主流的 Web 服务或者数据库环境是绰绰有余的。
网络性能与三网延迟测试
对于一台位于美国东海岸华盛顿的 VPS 来说,国内用户最关心的莫过于它的网络速度和延迟表现了。为了测试它在全球主要节点及中国大陆的真实网络质量,我在中午的网络高峰时段运行了 Speedtest 测速脚本以及三网 Ping 值检测。
全球主要节点带宽与延迟
首先,我们通过 Speedtest 脚本测试了这台华盛顿 VPS 对全球几个核心区域的上传与下载速度。
| 节点名称 (Node Name) | 上传速度 (Upload) | 下载速度 (Download) | 网络延迟 (Latency) |
|---|---|---|---|
| Speedtest.net (本地) | 102.73 Mbps | 99.01 Mbps | 242.35 ms |
| 法国 巴黎 (Paris, FR) | 99.26 Mbps | 105.64 Mbps | 78.13 ms |
| 日本 东京 (Tokyo, JP) | 102.83 Mbps | 102.35 Mbps | 180.66 ms |
| 中国 上海 (Shanghai, CN) | 99.40 Mbps | 100.32 Mbps | 187.97 ms |
| 中国 香港 (Hong Kong, CN) | 3.98 Mbps | 4.96 Mbps | 216.44 ms |
从测试表格中可以看到,除了香港节点的速率出现了较为明显的劣化之外,无论是欧美本土还是亚洲的上海、东京节点,基本上都能稳定跑满 100 Mbps 的带宽上限。这说明 LightNode 提供的基础出口带宽没有严重的限速,国际通用性相对较好。
国内三网延迟表现
接下来,我们聚焦于国内普通用户最在意的延迟指标。以下针对中国电信、中国联通和中国移动三大运营商的测试结果。
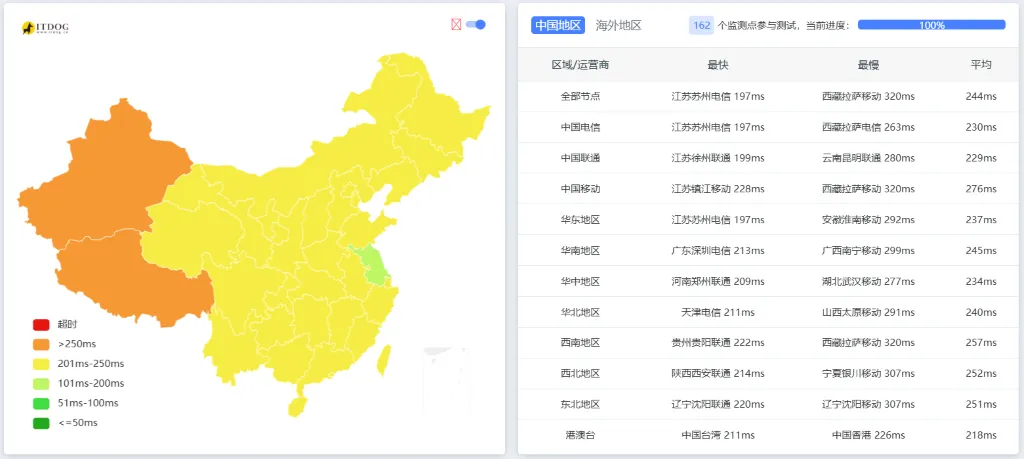
为了让大家更清晰地对比三大运营商的整体表现,我将截图中的核心数据整理成了下表:
| 运营商类型 | 最优节点延迟 | 最差节点延迟 | 三网综合平均 |
|---|---|---|---|
| 中国电信 | 江苏苏州电信 197ms | 西藏拉萨电信 263ms | 230ms |
| 中国联通 | 江苏徐州联通 199ms | 云南昆明联通 280ms | 229ms |
| 中国移动 | 江苏镇江移动 228ms | 西藏拉萨移动 320ms | 276ms |
通过数据可以看出,由于地理位置处于美国东海岸,国内沿海地区的最好成绩也需要 190ms 以上,而内陆或偏远地区则会飚到 260ms 到 320ms 左右。移动网络的整体延迟比电信和联通还要略高一些。
路由追踪与延迟原因分析
为了探究这种延迟表现背后的根本原因,我进一步对这台服务器进行了回程路由追踪。
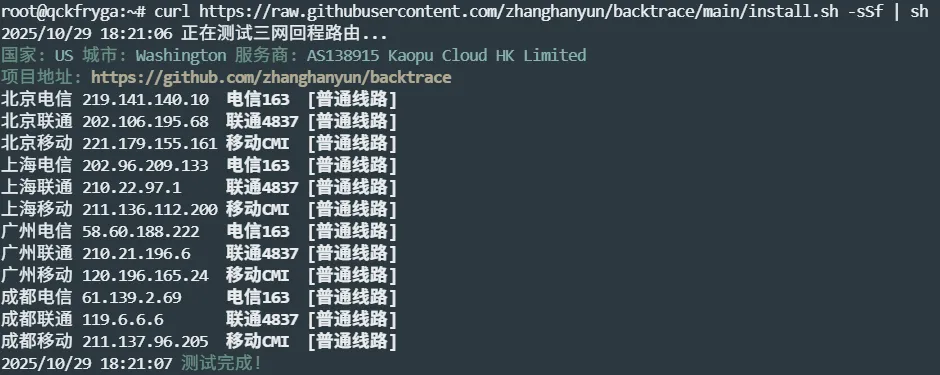
通过路由链路分析可以发现,该节点的网络属于回程三网普通直连。它并没有像搬瓦工等高端厂商那样,配备诸如 CN2 GIA、AS9929 或 CMIN2 等中国大陆方向的专属优化线路。属于典型的美国东部普通国际线路的表现,更适合面向欧美本土业务。
IP 质量与流媒体解锁测试
选购 VPS 时,IP 的纯净度和流媒体解锁能力也是很多站长非常关注的指标。特别是对于有特定业务需求或者想要兼顾日常娱乐的朋友来说,一个干净的 IP 能省去不少麻烦。接下来我们就对这台华盛顿实例的 IP 地址进行全方位的体检。
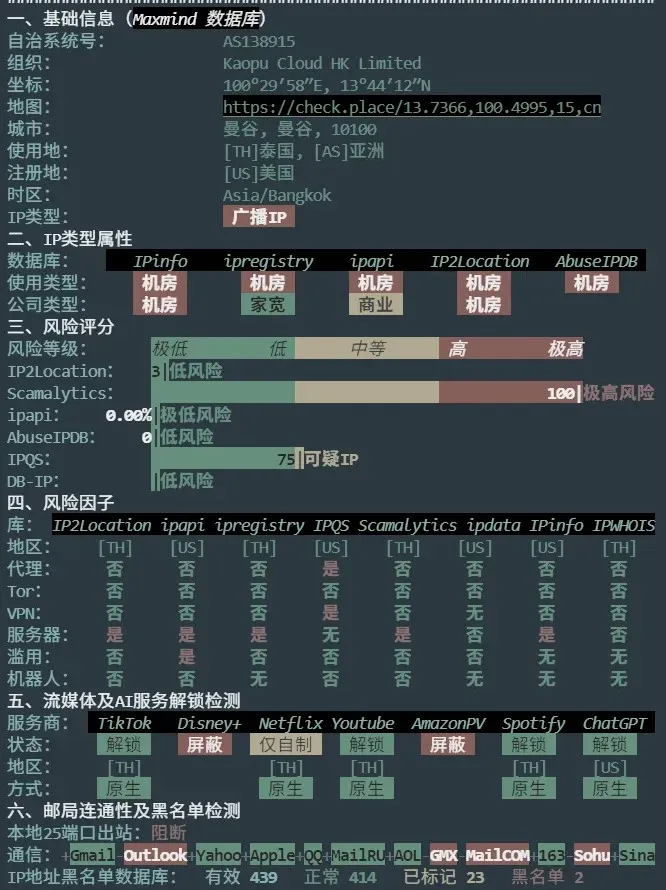
从上面的综合检测结果来看,这台机器分配到的 IP 整体还是非常干净的,没有出现被主流安全数据库大面积拉黑的情况。虽然通过细致查询发现它是一个广播 IP ,但整体的业务风险评估依然处于较低的水平。用它来建站或者作为常规的后端服务器,是完全没有问题的。
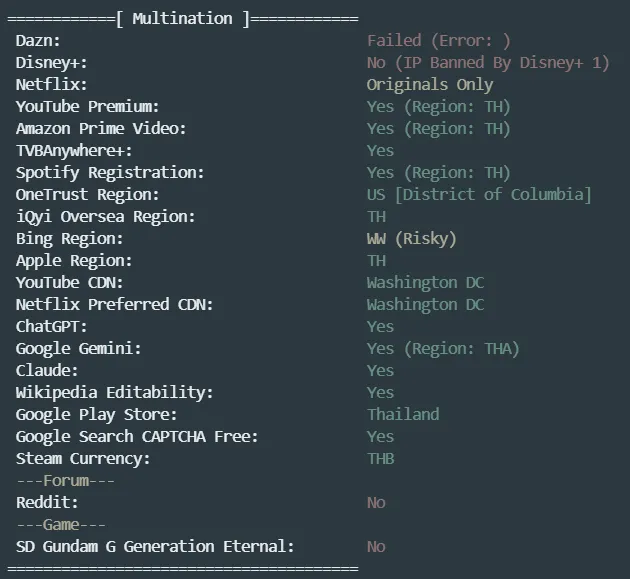
至于大家喜闻乐见的流媒体解锁环节,这台机器的表现就有些差强人意了。
根据脚本的探测结果显示,它虽然能解锁部分海外流媒体平台,但平台定位的地区大多被识别为了 TH (泰国)。如果你购买 VPS 的核心需求是为了大面积解锁原生的美区流媒体库,那么 LightNode 可能并不适合你,这种情况下我更建议你选择像 丽萨主机 这类商家。
总结
综合以上各项实测数据来看, LightNode 华盛顿节点的表现可以说是喜忧参半。
它的底层硬件配置十分扎实,尤其是 NVMe SSD 的读写性能在同价位产品中极具竞争力,能够轻松应对常规的网站数据库读写和后端计算需求。如果你主要面向欧美用户群体开展业务,或者仅仅是作为个人的开发测试环境,那么这款实例的性价比是非常高的。
但是,如果你打算将它作为主要面向国内用户的建站服务器,就需要考虑一下它缺乏针对性优化线路的问题了。大约两百多毫秒的直连延迟,对于追求极速秒开的互动型网站来说确实是个短板,建议搭配 Cloudflare 等免费 CDN 来改善国内的访问体验。
想要亲自上手体验这台高性价比的共享 CPU 机器,可以点击访问 LightNode 官网 获取最新的套餐详情与开通指引。
常见问题解答 (FAQ)
Q1:LightNode 支持类似 Vultr 那样的随时销毁/退订吗?
+Q2:华盛顿节点的网络延迟偏高,会对 SEO 优化有负面影响吗?
+对于主要做国内搜索引擎流量的站点来说,过高的基础延迟确实会增加网页的加载时间,确实会影响搜索引擎爬虫的抓取效率。不过,只要你妥善利用页面静态化缓存和 CDN 内容分发网络,就能极大程度地弥补物理链路上的劣势。
如果是瞄准谷歌海外流量的英文站点,华盛顿节点的地理位置反而是一个不错的加分项。