在之前的文章中,我们对 HostDare 的背景、机房方案以及定价策略做了初步整理。不过对于 VPS 而言,官网给出的参数往往只是 “参考”,实际的网络质量和机器性能到底如何,仅看规格表是远远不够的。
为了给选购提供真实的参考,我们开通了一台 HostDare 的实例,并进行了为期数日的性能跟踪。本篇测评不带主观色彩,我们将通过三网路由追踪、晚高峰网络压力测试、CPU 算力以及磁盘 I/O 等维度,直接展示原始抓取数据。
HostDare 到底是性价比之选,还是言过其实?接下来的实测数据会给出答案。
在进行各项压力测试和网络抓取之前,我们需要先明确本次测评所使用的机器环境。
本次测试选择了 HostDare 的入门级 NVMe 套餐(CSSD0),该套餐因其较低的准入门槛,常被用于搭建个人博客或轻量级后端服务。
测试用配置概览
在进行各项压力测试之前,需要先明确本次测评所使用的机器规格。本次我们开通的是 HostDare 的入门级 NVMe 套餐(CSSD0)。对于个人博客或轻量级后端服务来说,这款机器的年付门槛较低,是比较典型的起步方案。
官方标称的具体参数如下:
| 套餐名称 | CPU | 内存 | 硬盘 | 带宽/流量 | 价格 | 购买链接 |
|---|---|---|---|---|---|---|
| CSSD0 | 1 Core | 768 MB | 10 GB NVMe SSD | 30 Mbps 优化线路 / 250 GB 每月 | $35.99/年 | 立即购买 |
从表面数据来看,该方案的核心亮点在于 NVMe 硬盘,而 250 GB 的月流量相对偏少,更适合流量不高但对磁盘 I/O 有一定要求的独立站点。当然,官网参数只代表“理论分配”,VPS 市场中资源超开、硬件虚标的情况并不少见。
为了确认这台实例的真实底层环境,接下来我们直接通过 SSH 连入机器,执行基础指令,核实它的实际硬件分配情况。
实例环境实测数据
为了核实服务商是否存在资源超开或硬件缩水,我们通过 SSH 直连进入了这台 HostDare 实例。
首先,我们来看看这台机器的计算核心。对于一台入门级 VPS 而言,我们不奢求分配到最新的顶级芯片,但必须确认其架构是否稳定,避免被分配到过度老旧的淘汰硬件。通过基础命令,我们核实了具体的 CPU 型号:
[root@P20251019193912-001 ~]# lscpu | grep "Model name"
Model name:                      Intel Core Processor (Broadwell, IBRS)
从终端的反馈来看,系统采用的是 Intel Broadwell 架构处理器。在 KVM 虚拟化环境中,这是一款非常经典且成熟的型号。它虽然不是最新的高性能芯片,但胜在底层指令集支持完善且发热量低,应对个人博客、轻量级 API 接口,都是够用的。
我们接着排查内存与硬盘的真实分配情况。很多廉价 VPS 厂商喜欢在系统层面暗扣资源,导致用户的实际可用容量远低于标称值。
# 内存状态
[root@P20251019193912-001 ~]# free -h
              total        used        free      shared  buff/cache   available
Mem:           717Mi       204Mi       125Mi       1.0Mi       388Mi       397Mi
数据显示,系统识别到的总内存(total)为 717MiB。考虑到 Linux 内核本身会预留一部分基础内存,这个数值完全符合套餐标称的 768MB 规格。在基础运行状态下,目前可用(available)内存还有约 397MiB,没有出现严重的内存挤兑现象。
最后再看一下 NVMe 固态硬盘,磁盘这直接决定了后续系统 I/O 的读写瓶颈。我们查看了当前的文件系统挂载与使用情况:
# 磁盘状态
[root@P20251019193912-001 ~]# df -h
Filesystem      Size  Used Avail Use% Mounted on
/dev/vda1       9.8G  7.9G  1.5G  85% /
配置评价
从基础参数来看,HostDare 的 CSSD0 方案表现中规中矩。虽然 250GB 的月流量在同类竞品中不算充裕,但考虑到 NVMe 硬盘的读写优势以及较低的年付价格,对于追求稳定、流量消耗不大的个人博客或静态站点而言,性价比依然具备吸引力。
硬件配置只是基础,实际表现如何,还需要看接下来的性能跑分与网络链路测试。
基础性能压测:CPU 算力与 NVMe 读写
CPU 性能测试
首先,我们使用 sysbench 对这颗 Intel Broadwell 处理器进行单线程的算力测试,计算 10000 以内的素数,持续跑满 60 秒观察其稳定性。
[root@P20251019193912-001 ~]# sysbench cpu --time=60 run

CPU speed:
    events per second:  1038.94

General statistics:
    total time:                          60.0006s
    total number of events:              62339

Latency (ms):
         min:                                  0.90
         avg:                                  0.96
         max:                                  8.99
         95th percentile:                      1.03
         sum:                                59948.95
CPU 测试结果分析:
跑分结果显示,单线程得分为 1038.94 events/second。客观来说,这个成绩在目前的 VPS 市场中属于中规中矩的水平。它无法与最新的 AMD Ryzen 或 EPYC 系列的高频处理器的两三千分相比,但考虑到其入门级的定位和经典的 Broadwell 架构,这个表现是合格的。
同时,留意下方的 Latency 数据,平均延迟为 0.96ms,95% 的请求都在 1.03ms 内完成,最大延迟仅 8.99ms。这说明这颗 CPU 虽然算力不算顶尖,但在母鸡(宿主机)上的资源分配非常稳定,没有遇到严重的 CPU 偷跑或过度超卖导致的卡顿。
磁盘 I/O 性能测试
接下来,我们对这块主打卖点的 NVMe SSD 进行极端条件下的读写压测。我们使用专业的 fio 工具测试其 4K 随机写入和随机读取能力。
# 4K 随机写入测试
[root@P20251019193912-001 ~]# fio --name=randwrite --ioengine=libaio --iodepth=1 --rw=randwrite --bs=4k --size=1G --runtime=60 --time_based
# ... (省略部分过程输出) ...
Run status group 0 (all jobs):
  WRITE: bw=367MiB/s (385MB/s), 367MiB/s-367MiB/s (385MB/s-385MB/s), io=21.5GiB (23.1GB), run=60001-60001msec


# 4K 随机读取测试
[root@P20251019193912-001 ~]# fio --name=randread --ioengine=libaio --iodepth=1 --rw=randread --bs=4k --size=1G --runtime=60 --time_based
# ... (省略部分过程输出) ...
Run status group 0 (all jobs):
   READ: bw=22.0MiB/s (23.1MB/s), 22.0MiB/s-22.0MiB/s (23.1MB/s-23.1MB/s), io=1320MiB (1385MB), run=60001-60001msec


# 连续读写速度跑分汇总
----------------------------------------------------------------------
 I/O Speed(1st run) : 815 MB/s
 I/O Speed(2nd run) : 808 MB/s
 I/O Speed(3rd run) : 953 MB/s
 I/O Speed(average) : 858.7 MB/s
----------------------------------------------------------------------
磁盘 I/O 表现解析:
这组硬盘数据非常有意思,呈现出了明显的 “偏科” 现象:
- 极佳的写入与连续吞吐: 4K 随机写入高达 367 MiB/s(约 94k IOPS),而连续读写的平均速度更是达到了 858.7 MB/s。这证明了底层硬件确实是纯正的 NVMe 固态,且写入通道非常通畅。如果你要在上面跑数据库,落盘操作会非常丝滑。
- 受限的随机读取: 在 4K 随机读取测试中,速度被限制在了 22 MiB/s(约 5600 IOPS)。这在 NVMe 硬盘中是不寻常的,大概率是 HostDare 官方在母鸡层面针对 IOPS 做了 QoS(服务质量)限制,以防止“邻居”恶意扫描或高频并发读取拖垮整个存储池。
性能小结
综合 CPU 和磁盘的数据,这台 CSSD0 实例的定位非常清晰。
它不适合做高频并发读取的复杂计算节点,但如果你是用来部署前后端分离的项目、运行基于 SSG(静态站点生成)的现代前端框架,或者跑一个带 Redis 缓存的博客,它的性能表现可以说是游刃有余,性价比完全在线。
硬件底子看完了,下一节我们直接进入大家最关心的重头戏:网络路由与晚高峰连通性实测。
网络连通性与核心路由实测
首先,我们通过多节点测速工具查看了它在国内的整体延迟与丢包情况。
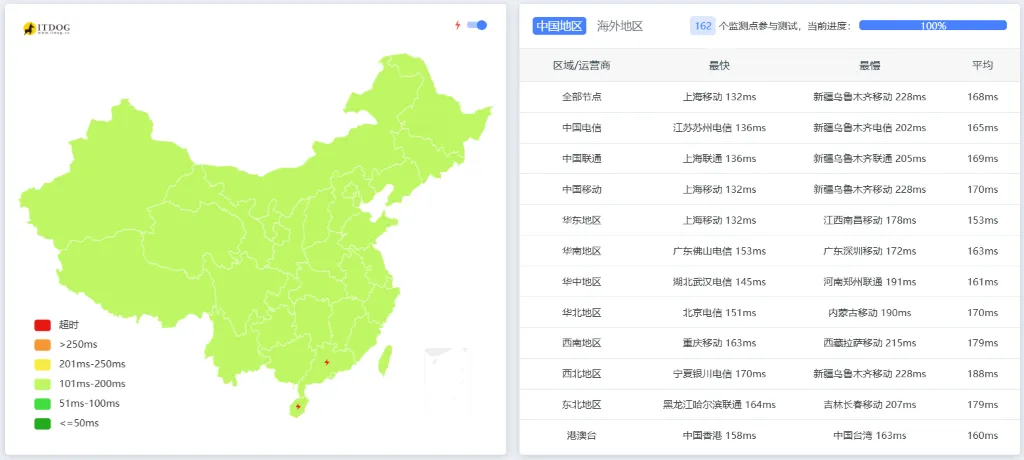
从图中看到这台 HostDare 实例到国内的平均延迟在 163ms 左右。客观评价,这个延迟数据肯定打不过搬瓦工这类顶级的纯血 CN2 GIA(通常能压到 130-140ms),但相比于常规 163 骨干网动辄 200ms 以上且红绿交错的延迟,163ms 已经相当优秀。
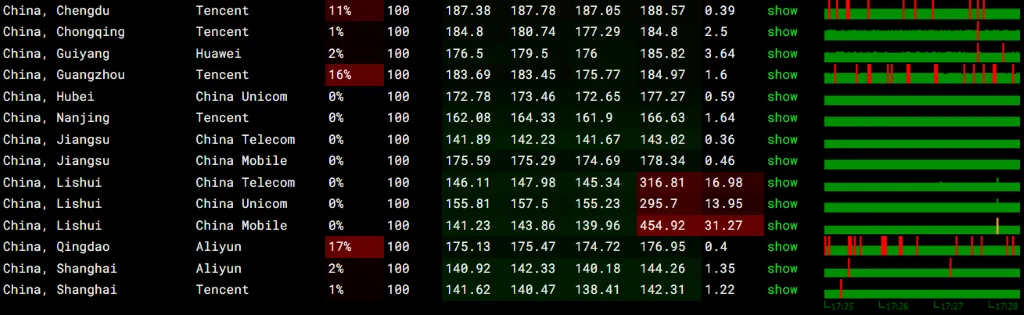
更让人惊喜的是它的丢包率极低,仅在 1% 左右。这对于维持 SSH 连接的稳定性以及前端页面的顺畅加载起到了决定性作用。
除了表面上漂亮的 Ping 值和丢包率,隐藏在数据背后的真实路由走向,才是决定网络质量下限的关键。很多机器虽然在非高峰期测速好看,但一到晚高峰跨国骨干网拥堵时,如果路由绕路,访问体验就会呈现断崖式下跌。
为了摸清这台机器的网络底子,我们直接运行了专业的 backtrace 脚本,对回程路由进行了一次完整的追踪抓取:
[root@P20251019193912-001 ~]# curl https://raw.githubusercontent.com/zhanghanyun/backtrace/main/install.sh -sSf | sh
国家: US 城市: Los Angeles 服务商: AS40065 CNSERVERS LLC
项目地址: https://github.com/zhanghanyun/backtrace
北京电信 219.141.140.10  电信CN2  [优质线路]
北京联通 202.106.195.68  联通9929 [优质线路]
北京移动 221.179.155.161 移动CMI  [普通线路]
上海电信 202.96.209.133  电信CN2  [优质线路]
上海联通 210.22.97.1     联通9929 [优质线路]
上海移动 211.136.112.200 移动CMI  [普通线路]
广州电信 58.60.188.222   电信CN2  [优质线路]
广州联通 210.21.196.6    联通9929 [优质线路]
广州移动 120.196.165.24  移动CMI  [普通线路]
成都电信 61.139.2.69     电信CN2  [优质线路]
成都联通 119.6.6.6       联通4837 [普通线路]
成都移动 211.137.96.205  移动CMI  [普通线路]
深度解析 HostDare CN2-GIA 路由策略
从上述回程追踪的数据中,我们可以提取出三个非常核心的技术细节。如果你打算用它来建站,务必留意:
第一,移动线路的“落差”。
细心的朋友会发现,移动的回程路由走的是 CMI(China Mobile International),而并非部分高端套餐宣传的 CMIN2 高端网络。不过从实际体验来看,单纯的 CMI 直连在目前的网络环境下表现依然坚挺,日常浏览网页不会有明显的阻滞感。
特别是电信(CN2)和联通(9929/4837)的表现则完全达到了优质线路的标准。
第二,单向优化的“建站红利”。
需要特别指出的是,HostDare 的这套网络方案是典型的“去程直连,回程优化”。
小白可能会觉得单向优化是服务商在 “偷工减料”,但对于网站站长而言,这种策略简直是量身定制。因为在 Web 访问的逻辑中,用户发给服务器的请求(去程)只是极小的文本数据(几十 KB),而服务器给用户的网页、图片和脚本(回程)更重要。
把昂贵的 CN2/9929 优质带宽全砸在“回程”上,能以最低的成本换来最极致的网页秒开体验。
第三,基于目标 IP 的智能路由策略(QoS)。
很多测试脚本在跑路由时会得出不同的结论,这是因为这种优质线路通常具有 QoS 策略:优化线路仅对 “家宽(家庭宽带)” 生效。
如果用户的访问 IP 来自于普通的家用网络,数据包会被自动调度到 CN2 或 9929 等优质链路上;但如果目标 IP 属于其他机房的数据中心,大概率会被识别并打回常规的普通直连线路。我们在测试中看到的移动 CMI 走向,很大程度也是受此机制的影响。
网络层面的解析就到这里。对于个人博客或中小型出海/评测站点来说,这个网络表现非常值了。
综合评价与选购建议
总体而言,HostDare 的核心竞争力可以概括为 “实用主义”。
它没有采用最顶级的硬件,单核 Broadwell 处理器在算力上只能算中规中矩,但它非常聪明地把成本花在了刀刃上——提供了表现优异的 NVMe 连续写入速度,以及对建站体验至关重要的回程网络优化。在目前的定价体系下,这种 “好钢用在刀刃上” 的策略,性价比极高。
为了方便大家对号入座,我们将具体的选购建议简要归纳如下:
- 个人博客与轻型建站: 首推本次测评的 NVMe 优化系列(如 CSSD0),利用回程优化低成本保障国内晚高峰的加载速度。
- 出海业务与大流量需求: 如果不需要回国优化,直接选择官方的 Cheap 系列,同等价格下能换取更大的流量与硬件配置。
- 重度运算与高并发场景: 建议避开入门级套餐,直接选择搭载高性能 AMD EPYC 处理器的进阶系列以消除 CPU 瓶颈。
买 VPS 就像配电脑,没有绝对完美的机器,只有最契合当前业务阶段的配置。HostDare 的入门实例并不完美,但它在“低预算”和“可用性”之间找到了一个极佳的平衡点,非常适合起步阶段的站长或个人开发者。
如果你目前的业务刚好契合上述的轻量化场景,建议直接 前往 HostDare 官网 查看最新的套餐库存与实时报价。
官方偶尔会放出一些额外的促销折扣,选购前多加留意,可以进一步降低你的建站成本。
常见问题解答(FAQ)
Q1:套餐里写的 250GB 流量够建站用吗?流量是怎么计算的?
+首先需要明确,HostDare 的流量是双向计费的(即服务器的流入和流出流量相加计算)。250GB 看似不多,但如果你只是用来搭建个人博客、图文展示站或轻量 API 服务,这个流量是绰绰有余的。在我的实际长期建站体验中,从未遇到过流量耗尽被停机的情况。
所以只要不挂载大型视频或做公共下载站,完全无需流量焦虑。
Q2:如果刚买到手,发现分配的 IP 被墙了(国内 Ping 不通)怎么办?
+这是很多新手最担心的问题。HostDare 官方提供了很好的兜底政策:支持 3 天无理由退款。
退款条件是你的资源使用量不能超过 20%。退款时可能会扣除约 0.5 美元的网关手续费,剩余款项会原路返回到你的支付账户。因此,建议新购机器交付后,第一时间使用 Ping 工具测试国内连通性,遇到被封的 IP 直接退款流程。
Q3:国内用户购买方便吗?支持什么支付方式?
+Q4:这台 768MB 内存的入门款,能安装 Windows 系统挂机吗?
+不能,官方也不支持这么做。
Windows 系统底层十分臃肿,目前 HostDare 明确规定,只有配置达到 2GB RAM 及以上的套餐,才支持安装 Windows 系统。这台 768MB 内存、10GB 硬盘的实例是纯为 Linux(如 Debian / Ubuntu)环境设计的。
如果是为了建站,请老老实实使用 Linux 系统,配合宝塔、1Panel 等可视化面板,操作其实比 Windows 更简单高效。
Q5:为什么测评里说 “只有回程是优化线路”,这不是半残线路吗?
+恰恰相反,这是极具性价比的 “建站专享” 策略。
用户发给服务器的请求(去程)只是几 KB 的指令,普通的直连网络完全能瞬间送达;而服务器把网页内容、图片吐给用户(回程)则高达几 MB 甚至更多。这样既能保证网页在国内的秒开体验,又能大幅压低机器的售价,对于站长来说是非常务实的方案。